本体:给"小境"装上数据库地图
主要报告思路
① 我们做了两种小境,一种只做Agent升级,另一种还带有本体模块
② 演示两种方案的运行表现,并报告对本体的原理和特性研究成果
③ 补充汇报:为了实现工程落地,我们总结了一套对 AI 系统进行评价的方法
去年的大屏版"小境",今年多了一个会自己探索的版本
去年 · AI 大屏版"小境"
- 一套固定的意图识别和固定的处理逻辑
- 问题范围和答案形态相对固定,专为大屏场景设计,响应速度要快
- 过程对用户不可见,不展示太多的过程信息
今年 · "小境"升级为Agent(智能体)
- 不限制问题类型,只规定思考的边界
- 会自主探索:通过多轮自我反省、逐步靠近答案
- 思考路线可解释:能看到它每一轮是如何分析问题的
- 执行过程可追溯:执行了哪些 SQL/Cypher、参数和结果,界面上全程展开
- 分析过程可干预:用户可以持续给提示,调整它的分析方向
- ⚠️ 升级的代价:回答变慢,过程信息很多,不再适合大屏实时场景。
Agent机制让"小境"可以自我修正
只有两处调用 LLM
Plan 进行意图识别、做好整体规划。写好第一批 SQL; Check 对执行结果做反思,判断还缺什么、整理出新的 SQL。 Do 不调用 LLM,只负责执行 SQL、返回结果,执行这一步确定、不产生幻觉。
根据内容和时间上线设置退出机制,避免空转
数据已经足够,交 Answer 组织结论返回用户; 轮次用完(系统设有最大轮次上限)也强制收口,把已查到的如实报告出来。
小境的运行过程
用户提问:平台上有多少个场景?
Plan · 规划(意图识别)
只知道有两个数据库:PgSQL 是知识库,MySQL 是业务库,决定去 MySQL 查业务表的结构。
返回:SHOW TABLES;
Do · 执行
在 MySQL 和 PgSQL 上各自执行 SQL,把结果返回。
Check · 检查和反思
缺失:字典表。整理新 SQL 交回 Do 再查;如果超过 4 轮,就强制收口。
── Answer ●(13.9s)──
根据平台现有的介绍信息,可以明确的一个应用场景是“出口应收账款融资场景”,该场景于2019年3月上线,已累计服务大量企业和银行网点。另外,平台资料中提到总共上线了15个应用场景,但未列出其他场景的具体名称,因此暂时无法提供完整的场景列表。
小境 Neo 的运行过程
用户提问:平台上有多少个场景?
Plan · 规划(意图识别)
Neo4j 增强(场景 → 术语 → 数据映射),场景清单的答案在本体里。
返回:MATCH (s:Scenario) RETURN s.number, s.name, s.description, s.aliases ORDER BY s.number;
Do · 执行
在 Neo4j 上执行查询,返回 15 行。
Check · 检查和反思
数据充足 ✓,无需第二轮。
── Answer ●(10.1s)──
小境为您梳理了平台上已定义的所有业务场景,共15个,具体如下:出口应收账款融资、出口信保保单融资、企业跨境信用信息授权查证、保税核注清单融资结算、中欧班列“长安号”融资、中欧班列“齐鲁号”融资、山东“港云仓”仓单融资、广西北部湾“港航融”、西部陆海新通道物流融资结算...
实际运行案例
出口场景上半年融资金额有多少?
大西瓜场景的融资额度有多少?
今年5月份的融资金额和融资笔数同比变化如何?
Neo4j 数据对象
本体在 Neo4j 里的节点按四个语义层着色,都从 Scenario 展开;各层含义见图例。 MATCH p=(Scenario)-[]->() RETURN p LIMIT 125;
Plan 阶段做了哪些检查
| 关注的方面 | 做什么 |
|---|---|
| 时间基准 | 把当前时间注入提示词,禁止 LLM 用它训练时的年份作答 |
| 意图路由 | 闲聊直接回答;数据查询才进入探索流程 |
| 查询策略 | 有本体:沿"场景 → 术语 → 数据映射"的 8 步链探索;无本体:SHOW TABLES → DESCRIBE → 推断 |
| 数据源选库 | 明细数据走 MySQL,趋势数据走 PgSQL,维度信息查 DataMapping |
| 参数化规范 | SQL 一律用 %s 占位符,配正反示例,参数数量严格对齐,禁止用 ? |
| 上下文复用 | 已经探明的表结构不再重复 DESCRIBE,前面的查询结果约束后面的查询 |
| 防御性规则 | 禁止跨库 JOIN;查询结果为空先排查原因再重试;探索查询加 LIMIT;禁止猜测表名 |
Check 阶段做了哪些检查
| 关注的方面 | 做什么 |
|---|---|
| 数据充足性 | 判断现有结果是否足以回答用户的问题 |
| 日期一致性 | 把查询里的日期值和当前时间基准对比,发现年份偏移 |
| 故障分类 | 按根因把失败分成三类:语法或参数错、表不存在、结果为空 |
| 修正策略 | 按故障类型决定方向:改写法、回头补元数据、还是重审查询条件 |
| 意图保持 | 修正时保留用户原来的意图,只改技术实现 |
| 收敛保护 | 同一原因连续失败两轮,自动降级为元数据探索,不重复同一个错误 |
额外写死的防御规则
| 规则 | 做什么 |
|---|---|
| 本体前置校验 | 有本体模式下,即使已有缓存结果,也必须先经 Neo4j 确认再查库 |
| Scenario 入口保护 | 禁止绕过 Scenario 节点直接查 DataMapping,保证每次查询有业务归属 |
| 大表保护 | 数据量不确定时,先 COUNT 查大小,再决定查询方式 |
| 参数不匹配回退 | 执行层捕获参数错误后,自动去掉参数重试一次 |
| 最大 PDCA 轮次 | MAX_PDCA_ROUNDS=5,超过自动收口,防止死循环 |
| DataMapping 归属隔离 | 同一张物理表被多个场景引用时,必须按 dm.scenario 区分归属 |
小境Agent
小境(只有Agent逻辑,无本体)
直接面对 MySQL、PgSQL 两张库的表,遇到问题从 SHOW TABLES 开始,靠表名和字段名猜。
小境 Neo:多了一张"本体"地图
小境 Neo(有本体)
同一个 Agent,中间多一层基于 Neo4j 的本体(领域知识模型 / 概念关系网络),查数前先"看图"。
图数据库 Neo4j vs 本体 Jena
本体是什么
本体(Ontology)
本体中不会存冗余的业务数据,而是解释业务概念、描述业务概念间的联系、记录实际业务习惯(习惯用语、缩略语)、业务规则(示例、要求、禁止)等。
澄清重要概念
- Neo4j:图数据库,本体就存在这里(节点 + 关系的形式)。专业的本体数据库比图数据库多一组推理机,关于推理机的概念后文具体汇报。
- 口径:口径是一个行业分析问题的惯例,比如当用户提到“查询业务规模”可能表示既关心金额,也关心交易笔数。
- 编排:控制 Agent 每一步干什么的固定程序,从实现上就属于 Harness 驾驭工程的范畴。
同一个问题:"平台上有多少个场景?"
小境(无本体)
思路:只知道 MySQL 是业务库、PgSQL 是知识库,先从表结构里找"场景"。
做法:SHOW TABLES 逐个看表名,再在资料里翻"场景"介绍。
回答:只说得出"出口应收账款融资"一个场景,其余含糊带过:"资料里提到共 15 个场景,但列不全。"
小境 Neo(有本体)
思路:问的是业务场景,先查本体里的 Scenario 节点,那里是场景清单的唯一出处。
做法:MATCH (s:Scenario) RETURN s.name,一条查询命中。
回答:把 15 个场景连同编号、简介、别名一次列全。
跟去年的版本相比,精简了部分功能
精简掉的功能
- 没有使用 FC 和 MCP(名词见右侧)
- 不绘制图表、不进行页面跳转
- 未开启语音输入、语音输出
- 上下文管理只用最简单的版本,另外把当前时间注入进去
名词
FC(Function Calling):让 LLM 按标准接口直接调用外部工具的能力。
MCP(Model Context Protocol):LLM 与外部数据源、工具对接的一种通用协议。
不用这两样,查询线路就完整地留在我们自己的代码和提示词里,界面上每一步都看得见。
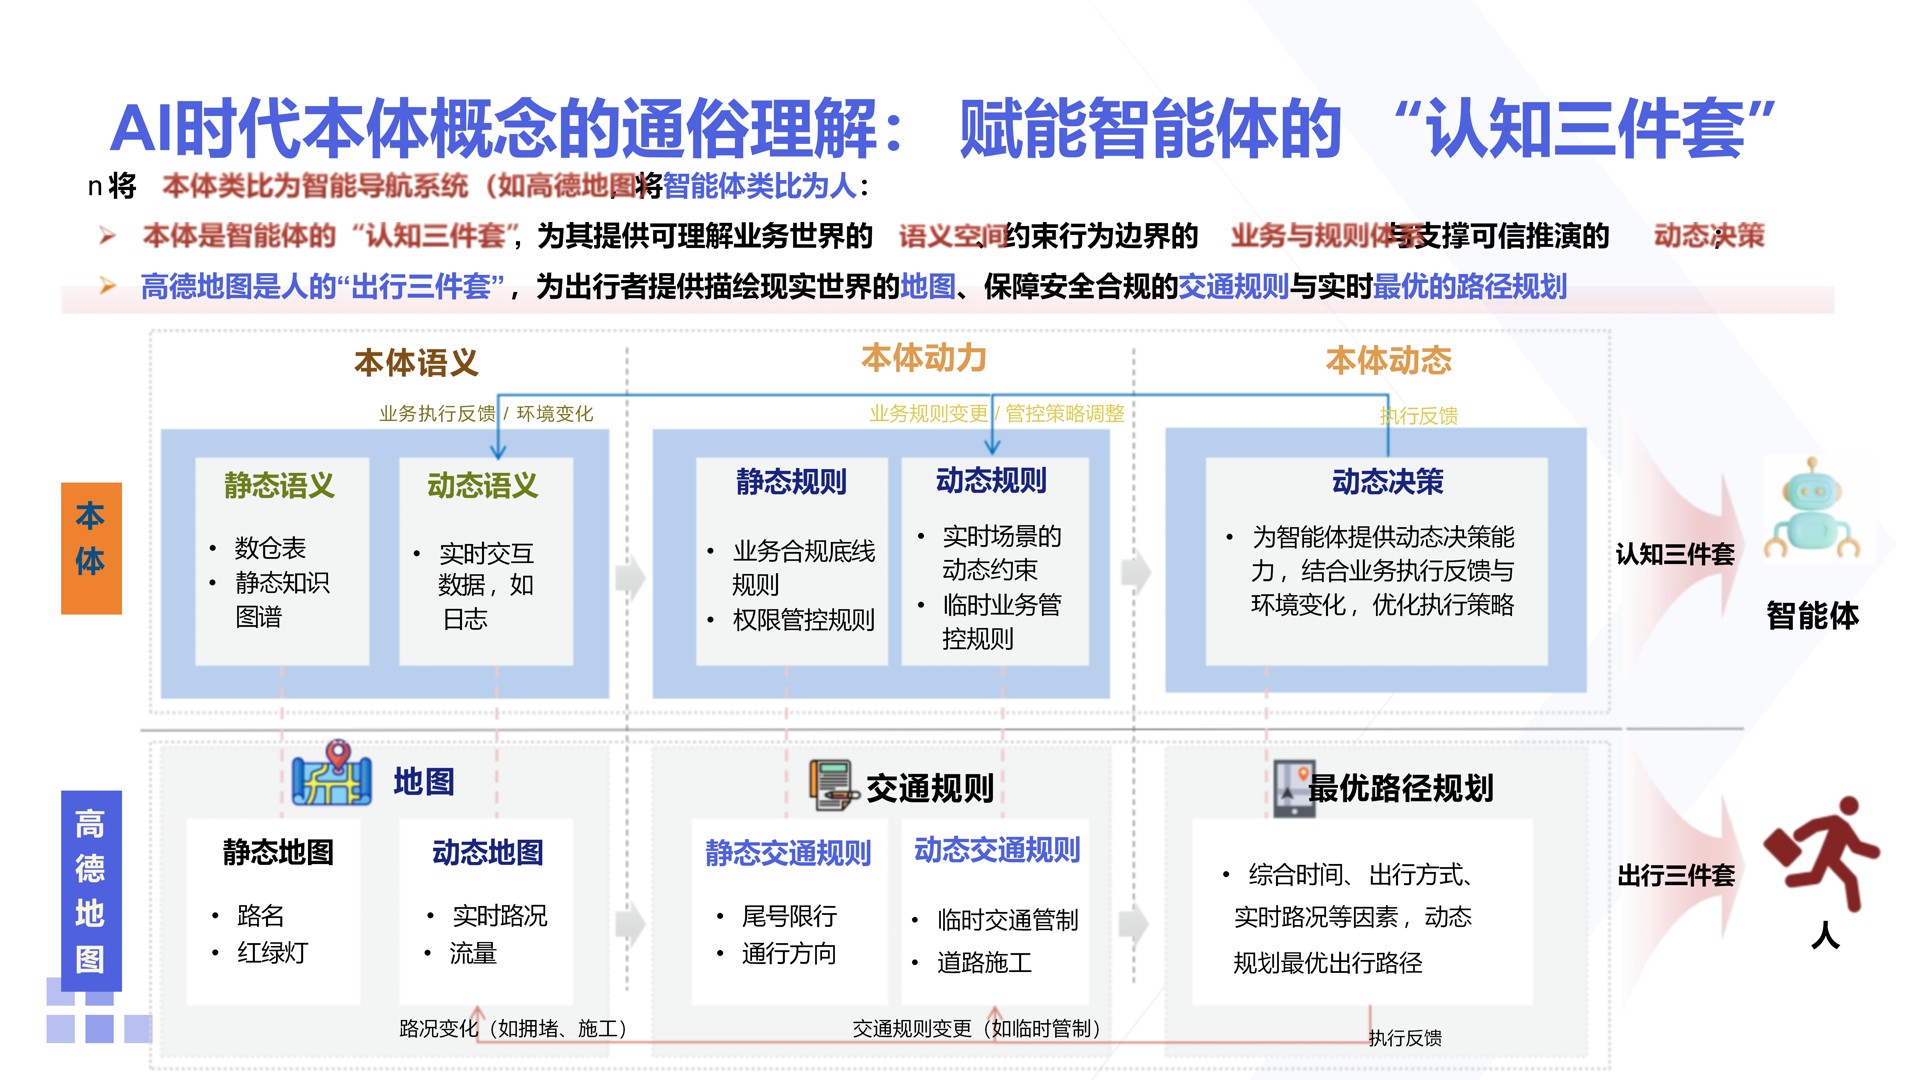
认知三件套:本体给 Agent 的,就像高德地图给出行者的
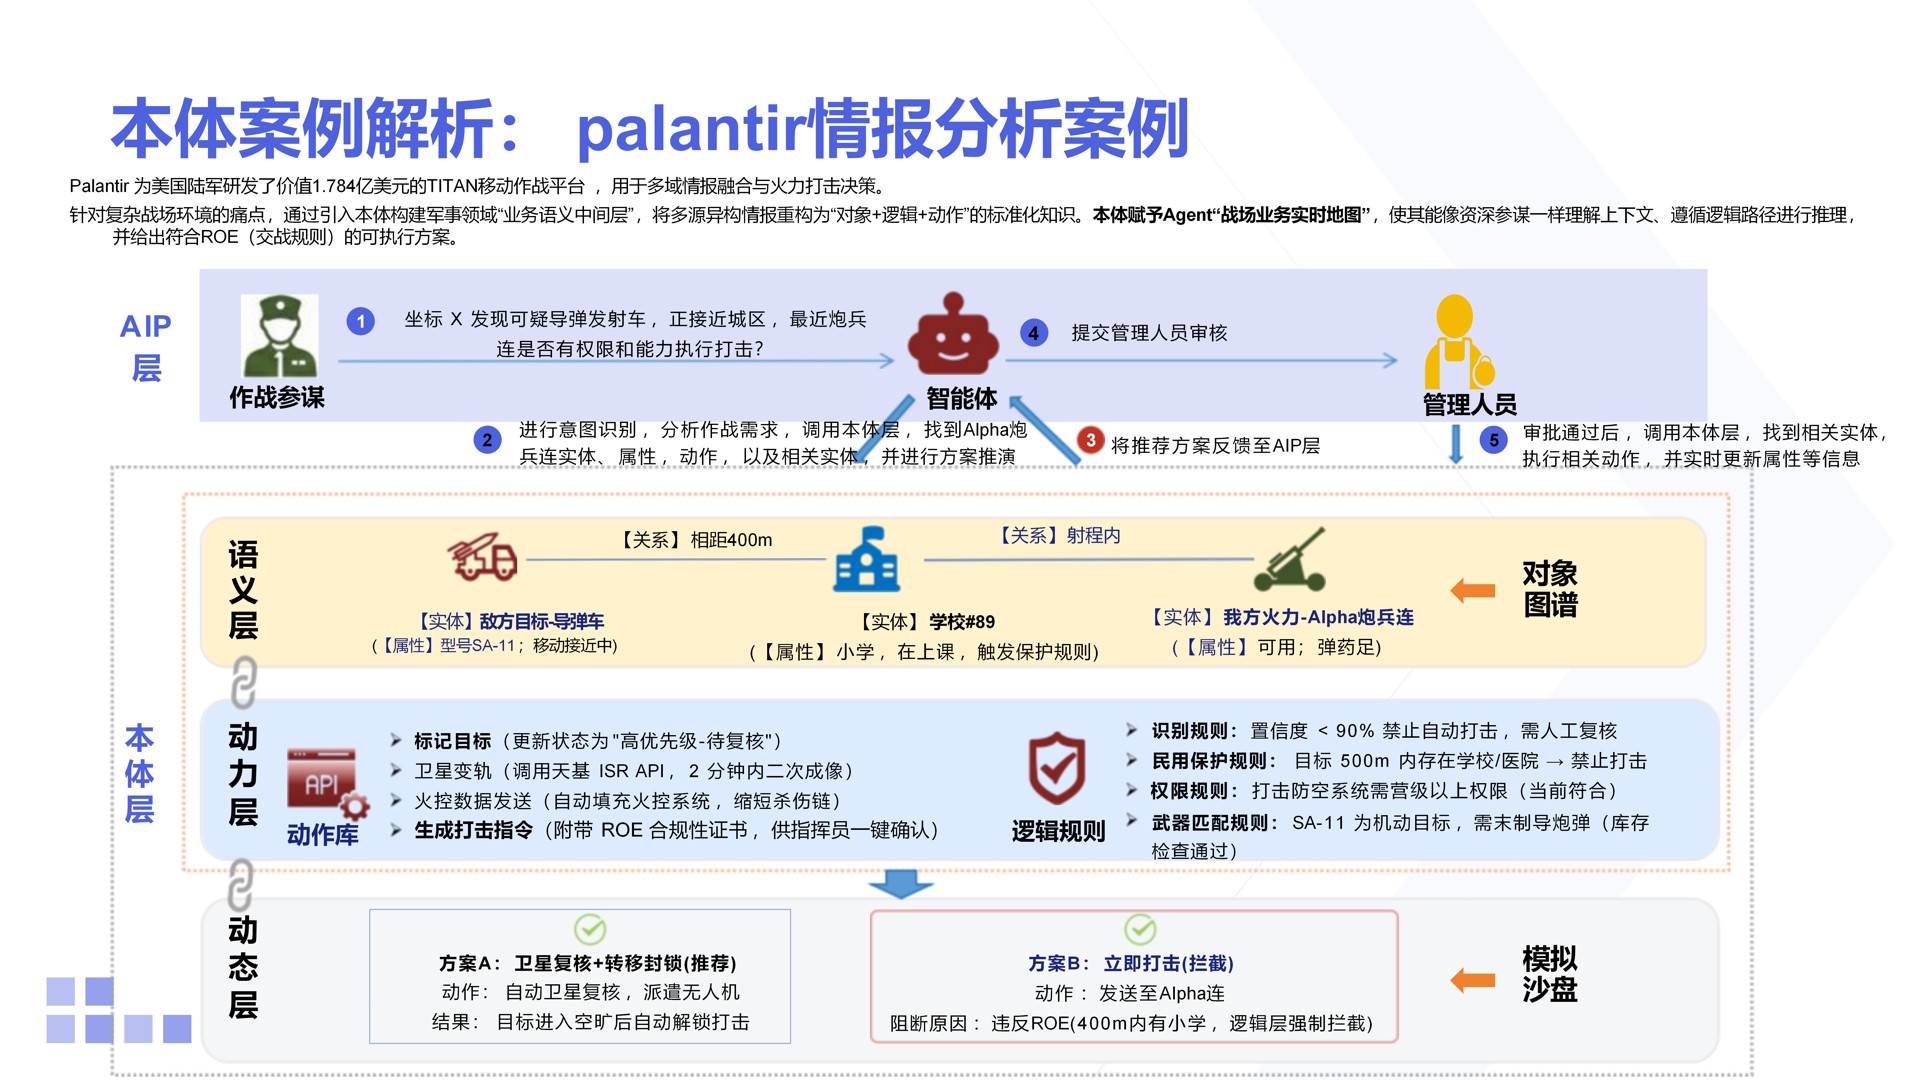
Palantir 情报分析案例:和本方案同构的"对象 + 逻辑 + 动作"
推理引擎(Reasoner):能推出没有存过的事实
本体数据库里存两类内容:事实,和规则。推理机根据已存的事实和规则,自动推出数据库里原本没有的结论;查询时,这些结论就像存在库里一样可见。
事实
张三 是一个 学生
规则
学生 是 人 的子类
推理机推出的新事实
张三 是 人 —— 这句话并没有存进数据库,是推理机推出来的
推理引擎可以与数据库配合
推理机是本体技术栈里的独立部件:在 RDF 体系里由 Apache Jena 这类框架提供,与"本体数据库"并列。后面三页依次看:怎么用、价值在哪、实际能推什么。
同一个问题,两种写法
以 Jena 为例:数据用三元组(主语–谓语–宾语)表示,下面两条数据用 Turtle 语法书写;查询语言是 SPARQL(RDF 的查询语言)。
ex:ZhangSan  rdf:type         ex:Student .   # 事实1:张三是学生(rdf:type 读作"是一个")
ex:Student   rdfs:subClassOf  ex:Person .    # 事实2:学生是人的子类(即规则)
不启用推理机:查询里自己走推理链
库里只有上面两条三元组,直接查"类型是人"查不到张三;要在查询里把"类型→子类"这条链手动走一遍:
SELECT ?x WHERE {
  ?x rdf:type/rdfs:subClassOf* ex:Person .
}
# 属性路径:先走一步 type,再走 0~N 步 subClassOf
启用推理机:查询直接按想要的写
用推理机把数据图包装成"推理图",隐含事实"张三是人"在查询时自动可见,查询退回到最简单的形式:
SELECT ?x WHERE {
  ?x rdf:type ex:Person .
}
# 按类型直查即可命中:推理机补全了隐含三元组
推理引擎的价值
| 做法 | 查询怎么写 | 优点 | 缺点 |
|---|---|---|---|
| 直接三元组匹配 | ?x rdf:type ex:Person | 查询最简单 | 看不到隐含事实 |
| 查询时手动推理 | ?x rdf:type/rdfs:subClassOf* ex:Person | 不用推理机,图数据库就能做 | 每次都要写复杂路径,复杂规则难组合 |
| 推理机自动推理 | ?x rdf:type ex:Person | 简单查询自动看到隐含事实 | 有推理计算 / 存储成本,需要配置 |
规则少的时候,拼装多跳查询是可行的;规则躲起来之后,规则之间开始互相触发,手写查询就会过于复杂。
实际的推理,远不止"子类多跳"
本体里常用的规则类型(OWL)
- 等价类(owl:equivalentClass)
- 逆属性(owl:inverseOf)
- 传递属性(owl:TransitiveProperty)
- 个体同一(owl:sameAs)
- 不相交类一致性检查(owl:disjointWith)
- 类交集(intersectionOf)与 hasValue 限制
这些全靠手写 SPARQL 会非常复杂,而且规则之间会互相触发,写不胜写。
推理机额外给的两样东西
规则变成系统能力:自动、全局、可组合地推导,查询保持简单。
推导追溯(Derivation):每条隐含事实都记录它由哪条规则、基于哪些原始事实推出;同一结论可能有多条推导路径。配合一致性检查报告(ValidityReport),既能发现矛盾,也能回放矛盾的成因——构成完整的本体调试能力。
Jena 内置推理机 RDFS 推理机(子类、子属性等基础规则) · OWL 推理机(等价类、不相交类等复杂语义) · 传递推理机(祖先关系这类传递关系) · GenericRuleReasoner(自己写规则,最灵活)。
完美落地前的 工程工作
把后续工作做好,最需要业务专家深度参与
希望得到的支持:请业务条线指定一位口径确认人
目前本体和题库里的术语、列语义、口径对不对,主要由工程侧根据资料和数据库推断,还没有经过业务方面的确认。希望业务条线指定一位口径确认人,参与两件事:本体评审(术语、列语义、口径定义)和题库口径核对(标准答案采用的统计口径)。以评审会或口径答疑的形式支持即可,不需要全职。后续修正本体、向其他场景复制时,都以业务确认的口径为准。
数据与访问
更多场景业务库的只读访问 + 口径清单,支撑"主场景方法向其余场景复制"。
算力(量小)
测评运行的 LLM 推理配额:一轮约 40–50 万 token,下一轮对照同量级。
设计测评方案的基础,是先分析好测评对象
用"员工、地图、翻译"打比方,把三个组件讲明白。
编排(Harness)
指挥流程的"员工"。接到问题后按固定节奏推进:先规划、再执行、再检查、再收尾。
本体(Ontology)
那张"地图"。业务术语和数据库字段的对照关系,帮助系统减少探索弯路。
执行(LLM)
那位"翻译兼执行者"。把问题翻译成查询语句,再把结果组织成通俗的答案。
测评相关的术语
| 名词 | 通俗解释 |
|---|---|
| 题库 / 测试用例 | 一组预先设计、附有标准答案的问题 |
| 标准答案 | 出题人预设的正确结果,用于对照 |
| 指标 | 衡量表现的标准,例如探索轮次、响应时长 |
| 收敛 / 收敛性 | 系统经过若干轮探索后,能否在合理轮次内找到答案并停止。反复探索无法停止、该停时未停、过早停止导致遗漏答案,都属于收敛不佳 |
| 基线 | 用于对比的"上一版本"或"基准版本" |
| 快照 | 每场实验的条件记录(题目、数据、组件版本、时间),供复现与核对 |
| Token | 大模型处理文本的计量单位,大致对应算力与成本 |
| 归因 | 判断表现变化的原因,明确归属到哪个组件(编排 / 本体 / 执行) |
为什么不能只看"答案是否正确"
仅看最终答案,会忽略三类重要信息:
过程
答案正确,但探索轮次过多、资源消耗过大。
可信度
答案正确,但过程中曾"编造"数据,可靠性存疑。
定位
答案错误,却难以判断是流程、本体还是执行环节的问题。
评测要回答的两个问题
① 这次改动,评分是提高还是降低?
② 评分提高或降低的原因,主要归因于哪个组件(编排 / 本体 / 执行)?
评估分两层:底层"指标",上层"分数"
七个过程指标
原始数据:过程质量、效率与成本
按权重归因
把指标分配到三个组件
三张组件分数卡
编排 / 本体 / 执行,各一个 0–1 分
指标是什么
从每次执行记录(日志)里统计出的原始数值,例如平均探索轮次、正确率、Token 消耗、耗时,相当于评估的"底账"。
分数是什么
把指标按归因权重折算成 0–1 的展示分,例如编排分、本体分、执行分,相当于评估的"结论"。
七个过程指标(上):正确性与探索效率
| 指标 | 说明 | 对应问题 |
|---|---|---|
| ① 探索轮次 | 从提问到答完,循环执行的轮数 | 探索了几轮才得到答案? |
| ② 结果正确性 | 最终答案与标准答案的符合程度 | 答案是否正确? |
| ③ 查询质量 | 中间生成的查询语句质量(语法 / 选库 / 冗余) | 查询方式是否正确? |
| ④ 事实一致性 | 过程中是否存在前后矛盾或编造字段的情况 | 前后是否自相矛盾? |
七个过程指标(下):完整性与资源效率
| 指标 | 说明 | 对应问题 |
|---|---|---|
| ⑤ 回答完整性 | 一个问题的多个子需求是否全部覆盖 | 是否遗漏了子问题? |
| ⑥ Token 消耗 | 消耗的算力和成本 | 资源消耗是否过高? |
| ⑦ 结论生成时间 | 从提问到生成答案的等待时长 | 等待时间是否过长? |
三个组件各自考察什么
编排
- 探索轮次是否合理、能否及时停止
- 是否存在重复探索
- 前后口径是否一致
- 回答是否完整
考察目标:探索收敛快、事实不漂移、回答不漏项、无重复劳动。
本体
- 数据库与表的选择是否正确
- 术语解析是否准确
- 本体是否提升了探索效率
考察目标:选对库表、术语解析准确、探索更高效。
执行(LLM)
- 查询语句语法是否正确
- 语义是否贴合问题
- 数值是否准确
考察目标:语法正确、语义贴题、数值准确。
归因:指标如何归属到组件
每个指标对三个组件的责任权重不同:●● 主导、● 参与、○ 边缘。
| 指标 | 编排 | 本体 | 执行 |
|---|---|---|---|
| 平均探索轮次 | ●● | ●● | ● |
| 结果正确性 | ●● | ●● | ● |
| 查询质量 | ● | ● | ● |
| 事实一致性 | ●● | ●● | ● |
| 回答完整性 | ●● | ○ | ● |
| Token 消耗 | ●● | ●● | ● |
| 结论生成时间 | ● | ●● | ○ |
一条流水线:出题 → 执行 → 评分 → 报告
① 出题
准备题库
② 执行
自动向系统提问
③ 评分
自动 + 人工
④ 报告
生成报告
第一步 · 出题(题库)
一套标准题目以 15–20 道为宜:题太少缺乏统计意义,太多则单次评测耗时较长。
难度
- 简单:单表
- 中等:多表
- 困难:模糊表达 + 跨库
类型
- 精确查询
- 聚合统计
- 排序筛选
- 跨库联合
边界
- 无结果
- 歧义表达
- 超出本体覆盖
每道题附带三样东西:标准答案、预期轮次、子问题数量,后两样供评分和完整性检查使用。题目的口径以业务方意见为准,工程侧负责把题出规范、整理成格式。
第二步 · 执行:自动向系统提问
评测工具自动把每道题发送给被测系统,通过接口交互,不接触系统代码。
完整记录全过程:每一轮的"计划 / 执行 / 检查"、每条查询语句、最终答案、耗时、Token,全部留档。
结果按日期归档,避免多次评测相互覆盖。
第三步 · 评分
评分分三层:规则引擎自动判,人工标注补语义判断,最后综合成结论。
规则引擎(自动)
可自动计算的指标自动完成:探索轮次、结果正确性、Token 消耗、耗时。
人工标注
语义是否贴题、查询是否冗余这类项目由人工判断。这一步目前靠人工做,每轮结果都有复核留档。
综合评分
三层各自独立演进,最后统一输出"三组件分数 + 证据"。
分数必须附带证据,不能只给数值。每个分数都能回翻到具体的轮次记录、查询语句和统计口径。
第四步 · 生成报告:两类报告
单模型报告
单个方案的总结,包含三模块水平、七维指标和逐题证据。
对比报告
两个方案的对比,比较各维度差异、差距大小与原因。
共同特点
- 纯网页格式,无需服务器,离线可查看;顶部两个标签互相跳转
- 全部展开、滚动阅读,无需点击展开
- 使用业务语言(编排 / 本体 / 执行),不出现内部代号
四条关键原则
1 一次只更换一个组件
控制变量,才能归因。
2 统一契约
任何评测最终都输出同一套三组件分数。
3 分数必带证据
每个数值都能追溯来源。
4 使用业务语言表达
采用编排 / 本体 / 执行等说法,不用内部代号。
一个已知短板:收敛性尚未完整评测
该系统依靠多轮推理后给出答案,最需要考察的是能否做到"探索适量、及时收敛"。目前的评测尚未完整覆盖这一点。
目前可观测的指标
- 探索轮次是否合理
- 是否存在重复查询
- 是否存在前后矛盾(事实漂移)
三个盲区
- 仅看平均值会掩盖个别题目严重发散的情况,长尾问题无法体现
- 只惩罚轮次过多,轮次过少但答案错误反而被判定为良好
- 缺少明确的"收敛率"指标:有多少题目在合理轮次内给出正确答案
一次真实修复:测评把"没变好"也解释清楚了
变更:asset_state 大小写统一(本体 v0.0→v0.1,git b08eb26)。这是"本体质量修复前后",不是"有/无本体",后者看下一页的测试报告。
修复前后对比
| 指标 | 修复前 | 修复后 |
|---|---|---|
| 连续下钻 · 编排分 | 0.2778 | 0.6528 ▲ |
| 重复探索命中 | 4 | 1 ▲ |
| 跨轮复用率 | 50% | 62.5% ▲ |
| 单题平均耗时 | 103.75 s | 80.0 s ▲ |
| 单题正确率 | 25% | 25%(未变) |
| 下钻事实命中率 | 16.7% | 0% ↓ |
样本量小:单题 n=5(旧题库)+ 1 个会话,没有统计显著性,只能说明机制有效。自动判分是字符串近似规则(107 判得偏宽、102/103 漏匹配),已人工复核覆盖。
正确率没涨,三条归因都找到了 负结果主动讲
- 历史表干扰选表:clean_export 与 asset_info 并存
- 标准答案口径错配:题目的参考口径本身有问题
- 会话记忆未跨请求接线:测的是"无记忆 Agent"
这说明了什么
过程变好被度量到了,结果没变也被解释清楚了。口径差异会伪装成能力差异,这正是受控测评的价值。
本体对提高准确性有帮助
同一个 LLM(deepseek-v4-flash)、同一个 Agent(b08eb26),8 道题同一天、同一库,唯一变量是有无本体。16/16 次请求全部成功。
| 题(难度 · 类型) | 无本体 | 有本体 | 看点 |
|---|---|---|---|
| 101 放款额合计(M · 本体敏感) | ✗ 用错场景表 | ✓ | 有本体精确 422,694,000 元 / 59 笔 |
| 004 金额同比(H · 对照) | ◐ 数值十倍级错乱 | ✓ | 591,493,262 / 773,866,465 / −23.6% 全对 |
| 103 笔数(M · 本体敏感) | ◐ 75 与 59 摇摆 | ✓ | 干净答"59 笔" |
| 107 审核中笔数(E · 本体敏感) | ✗ 未答出 6 笔 | ✓ | 精确答"审核中 6 笔 / AUDITING" |
| 102 币种枚举(E · 本体敏感) | ✓ | ✓ | 两组都对(自动判级因顺序漏配) |
| 105 法规依据(M · 本体敏感) | ✓ | ✓ | 有本体更快:1 轮 vs 2 轮 |
| 003 融资金额(M · 对照) | ✗ | ✗ | 两组错在同一个口径 → 本体缺金额口径规则 |
| 108 机构层级(M · 本体敏感) | ✗ 找不到机构 | ✗ 上级答错 | 本体缺机构层级关系,下一步补上 |
这条链,本次 POC 完整跑通了一遍
知识显性化(本体)+ 语言泛化(LLM)+ 流程可控(编排)+ 度量可信(评测体系)。
本体把"对"的查法交给系统,LLM 把"懂"的语言交给用户;后面每一步改进,都用同一套带证据的测评来验证。业务专家补上口径这一环后,这条路可以复制到更多场景。
数字出处均可复核
调研笔记与评测留档(results/,含逐题证据与归档路径)。